

Ngày 21/10/2026, Google làm mới tài liệu chính thức “Kiểm soát những gì bạn chia sẻ với Google Search” và đồng thời phát hành video mới về robots.txt. Để kiểm soát việc Google — và cả AI — thu thập (crawl), lập chỉ mục (index), hiển thị trích đoạn (snippet) hay dùng nội dung của bạn để tạo câu trả lời AI, bạn có một “thang kiểm soát” gồm nhiều tầng: xóa nội dung, bảo vệ bằng mật khẩu, thẻ noindex, chặn crawl bằng robots.txt, các chỉ thị snippet (nosnippet, data-nosnippet, X-Robots-Tag) và tùy chọn “Search generative AI control” trong Search Console. Điều quan trọng nhất: mỗi công cụ kiểm soát một việc khác nhau, và dùng sai có thể khiến website biến mất khỏi tìm kiếm một cách không mong muốn.
Đây không phải tính năng mới. Google chỉ ghi lại chính thức các lựa chọn vốn đã tồn tại, nhưng chính việc gom chúng vào một trang giúp lộ ra bức tranh đầy đủ về quyền kiểm soát của chủ website trong kỷ nguyên AI Search — thời điểm mà nội dung của bạn không chỉ được xếp hạng mà còn bị “đọc”, “trích dẫn” và “đưa vào” các câu trả lời do AI tạo ra.
Google vừa thay đổi những gì trong tuần qua (10/2026)?
Theo Search Engine Land (Barry Schwartz, 21/10/2026), Google đã cập nhật tài liệu trợ giúp “Control what you share with Google Search” (Kiểm soát những gì bạn chia sẻ với Google Search) trên Google Search Central. Google nêu lý do cập nhật là “để giữ trang luôn mới và phản ánh đúng tập hợp lựa chọn hiện có dành cho chủ website”, và bổ sung “các lựa chọn sẵn có như thẻ meta robots, data-nosnippet, X-Robots-Tag, và Search generative AI control”.
Trước bản cập nhật, trang này liệt kê 5 phương pháp (bản dịch tiếng Ý/Đức còn ghi mốc 31/12/2025). Sau 21/10/2026, trang có 7 phương pháp — thêm hai hàng mới: (1) thẻ meta robots / data-nosnippet / X-Robots-Tag, và (2) Search generative AI control. Google nói rõ đây là “existing options” (các lựa chọn đã có), tức không ra mắt gì mới, chỉ tài liệu hóa đầy đủ hơn.
Gần như cùng lúc, Google phát hành tập 2 của series video “Non-Canonical Cabinet” với tựa “What can you actually put in a robots.txt?” (Bạn thực sự có thể viết gì trong robots.txt?), do Gary Illyes và Cherry Prommawin trình bày. Video giải thích rõ robots.txt làm được gì và KHÔNG làm được gì — mảnh ghép hoàn hảo cho câu chuyện kiểm soát nội dung.
“Kiểm soát chia sẻ với Google Search” là gì?
Kiểm soát chia sẻ với Google Search là tập hợp các phương pháp kỹ thuật cho phép chủ website quyết định Google được thu thập, lập chỉ mục, hiển thị và sử dụng phần nào trong nội dung của mình. Các phương pháp này xếp thành bốn tầng theo mức độ “sâu”: chặn thu thập (crawl), chặn lập chỉ mục (index), kiểm soát cách hiển thị trích đoạn (snippet), và kiểm soát việc nội dung được dùng cho các tính năng AI tạo sinh. Mỗi tầng dùng một cơ chế riêng và giải quyết một vấn đề riêng; không cơ chế nào thay thế được cơ chế khác.
Hiểu đúng “thang kiểm soát” này quan trọng vì một lỗi phổ biến là nghĩ rằng chặn trong robots.txt đồng nghĩa với việc trang biến mất khỏi kết quả tìm kiếm — điều hoàn toàn sai, như chính Google giải thích bên dưới.
7 cách giữ nội dung ngoài Google Search
Dưới đây là 7 phương pháp Google liệt kê trong tài liệu mới, theo đúng thứ tự và phạm vi áp dụng:
| Phương pháp | Chặn/áp dụng cho | Hiệu quả |
|---|---|---|
| 1. Xóa nội dung khỏi site | Mọi loại nội dung | Google gọi đây là “cách tốt nhất để đảm bảo nội dung không xuất hiện trên Google Search và bất kỳ đâu trên Internet”. |
| 2. Bảo vệ bằng mật khẩu | Mọi loại nội dung | Giới hạn truy cập cho người được phép; nếu nội dung đã xuất hiện, Google “sẽ dần gỡ bỏ”. |
3. Thẻ noindex |
Mọi loại nội dung | “Báo Google không lập chỉ mục và không cho nội dung xuất hiện trong kết quả.” Trang vẫn truy cập được qua link/trực tiếp. |
4. Chặn crawl bằng robots.txt |
Hình ảnh & video | “Google chỉ lập chỉ mục ảnh và video mà Googlebot được phép thu thập.” KHÔNG phải cách giữ trang web ra khỏi kết quả. |
5. Thẻ meta robots / data-nosnippet / X-Robots-Tag (mới) |
Tùy cách triển khai | “Dùng thiết lập cấp trang và cấp đoạn văn bản để điều chỉnh cách Google hiển thị nội dung trong kết quả.” |
| 6. Search generative AI control (mới) | Toàn site (per-property) | Quản lý việc site có mặt trong tính năng AI tạo sinh (AI Overviews, AI Mode). |
| 7. Loại khỏi thuộc tính Google cụ thể | Trang web | Giữ nội dung ngoài các dịch vụ như Google Shopping, Google Hotels, nhà nghỉ dưỡng. (AI features KHÔNG nằm trong nhóm này.) |
Bốn tầng kiểm soát: crawl → index → snippet → AI
Tầng 1 — Chặn thu thập bằng robots.txt (và điều video vừa làm rõ)
robots.txt là tệp văn bản thuần đặt ở gốc website, báo cho các bot biết chúng được/không được thu thập trang nào. Trong video mới, Gary Illyes nhấn mạnh tệp này tuân theo chuẩn internet RFC 9309, và bộ phân tích của Google đọc từng dòng, chỉ nhận bốn chỉ thị: user-agent, allow, disallow và sitemap. Dòng nào không hiểu, hệ thống “sẽ âm thầm bỏ qua” — nên một dòng kiểu “don’t crawl secret page” sẽ vô nghĩa và Google “vẫn có thể thu thập trang bí mật của bạn”.
Điểm mấu chốt cho người làm SEO: robots.txt chỉ là “giao thức ưu tiên truy cập”, không phải công cụ gỡ nội dung khỏi tìm kiếm. Một trang bị chặn trong robots.txt vẫn có thể được lập chỉ mục nếu Google phát hiện qua liên kết từ nơi khác (chỉ là Google không đọc được nội dung). Vì vậy Google xếp robots.txt vào nhóm dành cho hình ảnh và video, không phải cách giữ trang web ra khỏi kết quả.
Tầng 2 — Chặn lập chỉ mục bằng noindex
Muốn một trang web hoàn toàn không xuất hiện trong kết quả, bạn dùng thẻ noindex — qua thẻ meta robots trong <head> hoặc header HTTP X-Robots-Tag. Lưu ý quan trọng: để Google thấy được chỉ thị noindex, trang đó không được bị chặn trong robots.txt. Đây chính là cái bẫy kinh điển: chặn crawl + đặt noindex cùng lúc khiến Google không đọc được noindex, và trang vẫn có thể lọt vào chỉ mục.
Tầng 3 — Kiểm soát cách hiển thị trích đoạn (snippet)
Nếu muốn giữ trang trong kết quả nhưng kiểm soát cách Google trích dẫn, bạn dùng nhóm chỉ thị cấp trang/cấp văn bản:
nosnippet— không hiển thị bất kỳ trích đoạn văn bản nào cho trang.max-snippet:[số]— giới hạn độ dài trích đoạn (số ký tự).data-nosnippet— thuộc tính HTML cấp đoạn, đặt trên<span>,<div>,<section>để loại riêng một đoạn khỏi trích đoạn.X-Robots-Tag— cách khai báo các chỉ thị trên ở tầng header HTTP (hữu ích cho tệp không phải HTML như PDF).
Cảnh báo lớn: nosnippet loại nội dung khỏi AI Overviews, nhưng ĐỒNG THỜI gỡ luôn trích đoạn truyền thống (gồm cả featured snippet). Đây là công cụ “được ăn cả ngã về không” — trước khi có tùy chọn Search Console (xem Tầng 4), gần như không có cách nào giữ trang ngoài tính năng AI mà vẫn hiện bình thường trong tìm kiếm.
Tầng 4 — Chặn AI dùng nội dung của bạn
Đây là tầng “mới” và dễ gây nhầm nhất — có hai cơ chế hoàn toàn khác nhau mà nhiều người hay gộp làm một:
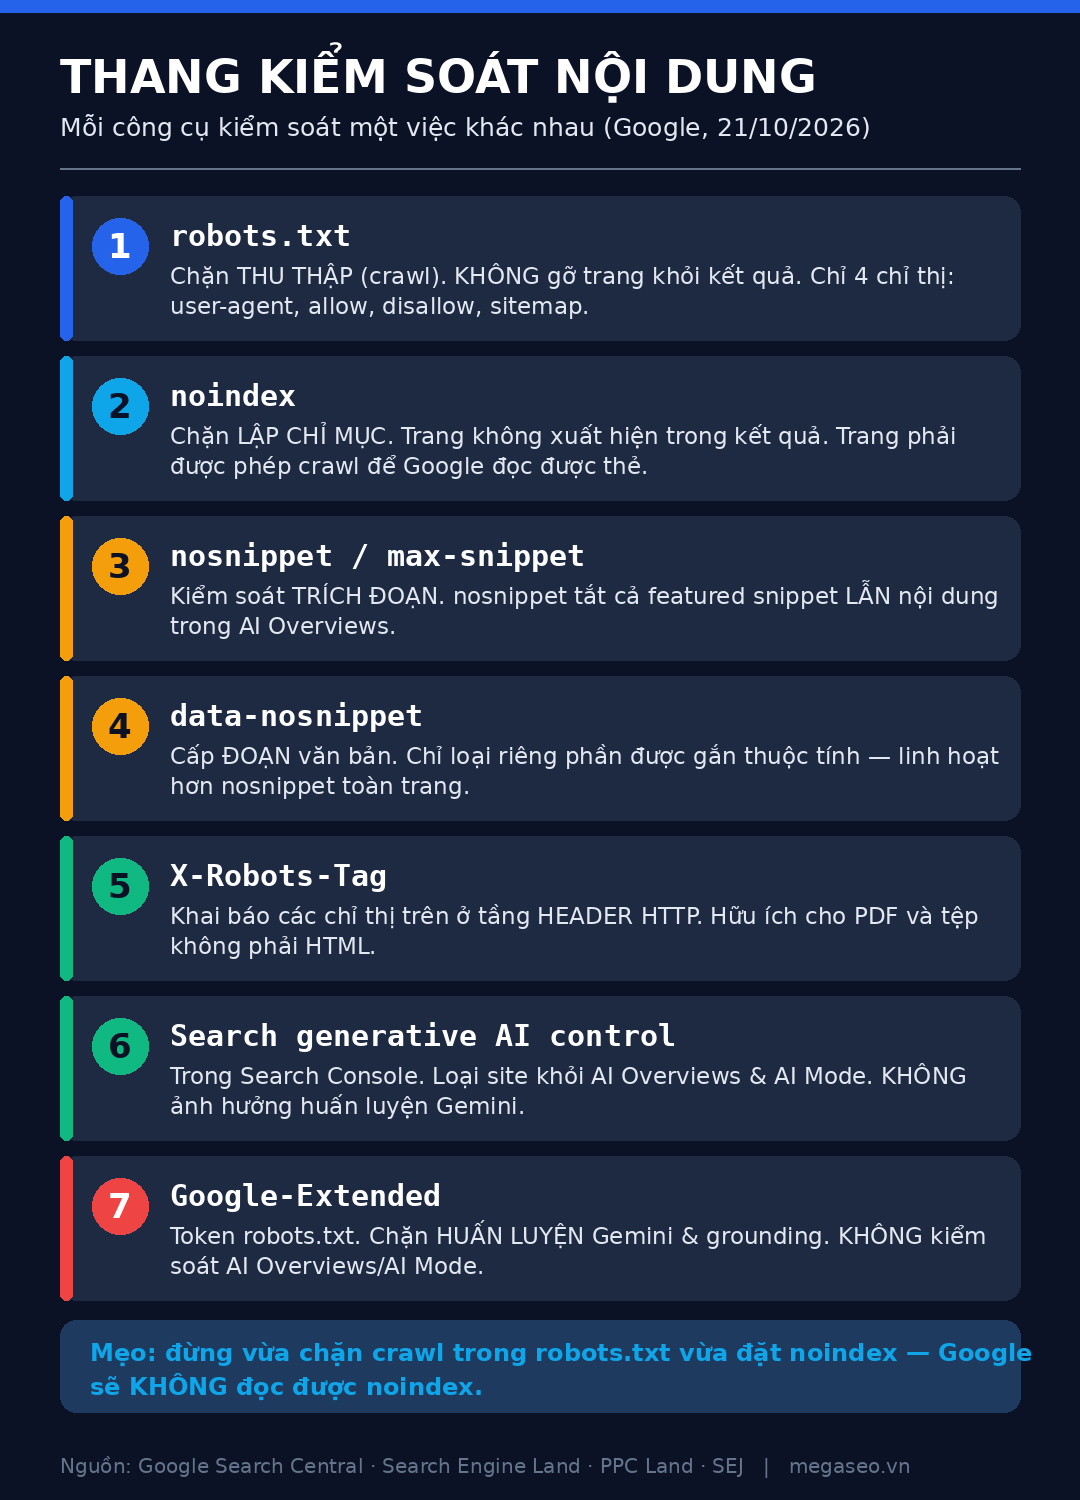
Search generative AI control nằm trong Search Console, mục Cài đặt (Settings), áp dụng theo property (không phải từng trang). Ba lựa chọn: include (mặc định), exclude, hoặc kế thừa từ property cha. Khi loại trừ, nội dung không còn được dùng làm đầu vào để tạo câu trả lời AI, và site không nhận hiển thị/lưu lượng từ các tính năng đó. Theo tài liệu, công cụ kiểm soát “các tính năng AI tạo sinh trên Google Search, gồm AI Overviews và AI Mode” (và AI tạo sinh trong Discover). Google bắt đầu tôn trọng thay đổi từ 17/6/2026, triển khai toàn cầu 31/8/2026; hiệu lực sau 1–2 ngày (bộ nhớ đệm có thể làm chậm). Lưu ý: tùy chọn này không ảnh hưởng xếp hạng chỗ khác, không ảnh hưởng việc huấn luyện AI, và không ghi đè thiết lập ở Merchant Center/Google Ads.
Google-Extended là một token trong robots.txt, kiểm soát việc nội dung đã thu thập có được dùng để huấn luyện các mô hình Gemini (Gemini Apps, Vertex AI API) và grounding hay không. Quan trọng: Google-Extended không điều khiển việc trang có xuất hiện trong AI Overviews hay AI Mode, “không ảnh hưởng việc site có mặt trong Search và không phải tín hiệu xếp hạng”. Vì vậy, muốn ở ngoài CẢ hai (vừa không xuất hiện trong AI Overviews/AI Mode, vừa không bị dùng huấn luyện Gemini), bạn cần dùng hai cơ chế: tùy chọn Search Console + một dòng robots.txt cho Google-Extended.
robots.txt không phải “tấm khiên” như nhiều người tưởng
Video mới của Google dập tắt vài hiểu lầm phổ biến mà người làm SEO Việt Nam hay mắc:
- Không phải cơ chế bảo mật. robots.txt công khai; nó chỉ là “ưu tiên truy cập” cho bot tử tế. Bot xấu bỏ qua hoàn toàn. Muốn giấu thật sự phải dùng mật khẩu/xác thực.
- Chỉ nhận 4 chỉ thị:
user-agent,allow,disallow,sitemap. Dòng lạ bị bỏ qua lặng lẽ — đừng tưởng một quy tắc “trông có vẻ hiểu được với con người” là đang hoạt động. - Không kiểm soát được việc dùng dữ liệu sau khi đã crawl. Gary nói rõ:
disallowchẳng liên quan gì đến việc dữ liệu có bị dùng để huấn luyện hay lưu trữ hay không. - Muốn chặn một AI crawler cụ thể thì phải nhắm đích danh user-agent token của nó trong tệp; không có “chặn tất cả AI” chung chung.
- Token user-agent chỉ gồm chữ cái và dấu gạch ngang — emoji không dùng được; với đường dẫn chứa ký tự không phải ASCII (tiếng Việt có dấu, emoji), nên dùng percent-encoding vì “crawler cũ hoặc khác có thể hiểu sai”.
Search generative AI control và Google-Extended khác nhau thế nào?
| Tiêu chí | Search generative AI control | Google-Extended |
|---|---|---|
| Nằm ở đâu | Search Console → Settings | Token trong robots.txt |
| Phạm vi | Toàn property | Theo đường dẫn robots.txt |
| Kiểm soát AI Overviews / AI Mode? | Có — loại khỏi hiển thị & làm đầu vào | Không |
| Kiểm soát huấn luyện Gemini / grounding? | Không | Có |
| Ảnh hưởng xếp hạng Search? | Không | Không |
Nói ngắn gọn: muốn ra khỏi câu trả lời AI của Google Search thì dùng tùy chọn Search Console; muốn chặn nội dung bị dùng huấn luyện Gemini thì dùng Google-Extended trong robots.txt. Dùng nhầm sẽ không đạt mục đích.
Góc nhìn Semantic SEO: kiểm soát cũng là một dạng thẩm quyền
Với phần lớn website, bài học từ đợt cập nhật này không phải “hãy chặn Google”, mà là hiểu đúng để không vô tình tự chặn mình. Trong kỷ nguyên mà nội dung được AI đọc và trích dẫn, mỗi quyết định kỹ thuật — crawl, index, snippet, AI — đều định hình cách thực thể (entity) và thẩm quyền chủ đề của bạn hiện diện trong hệ sinh thái tìm kiếm.
Dữ liệu tuần này củng cố quan điểm đó: ngày 22/10/2026, ba nghiên cứu độc lập (được Search Engine Land tổng hợp trong bài “ChatGPT sends less than 1% of Google’s traffic”) cho thấy các dịch vụ AI vẫn chỉ gửi một phần rất nhỏ lưu lượng so với Google Search. Nghĩa là: với đa số doanh nghiệp, mục tiêu vẫn là được Google thấy và được AI trích dẫn, chứ không phải rút lui. Quyền “tắt” chỉ thực sự hữu ích cho nhóm nhỏ (báo chí, nội dung trả phí, dữ liệu độc quyền) muốn bảo vệ giá trị thương lượng.
Semantic SEO vì thế không đổi trục: xây nội dung HTML sạch, có cấu trúc, gắn thực thể rõ ràng, để Google và AI hiểu đúng — thay vì lạm dụng noindex/nosnippet rồi tự đánh mất hiển thị. (Đọc thêm: Semantic SEO là gì và SEO thời AI Search 2026.)
Việt Nam cần lưu ý gì?
Các công cụ kiểm soát này mang tính toàn cầu và đã dùng được ngay tại Việt Nam (AI Overviews/AI Mode đã có mặt; tùy chọn Search Console triển khai toàn cầu từ 31/8/2026). Ba lưu ý cho SEOer Việt:
Thứ nhất, hãy rà soát xem mình có đang vô tình chặn nhầm không — một thẻ noindex sót lại từ môi trường staging, một dòng Disallow: / quên xóa, hay nosnippet đặt nhầm làm mất cả featured snippet. Thứ hai, đừng kỳ vọng robots.txt “giấu” được nội dung nhạy cảm — dùng xác thực/mật khẩu. Thứ ba, nếu là đơn vị báo chí/nội dung trả phí cân nhắc rút khỏi AI Overviews, hãy cân đo kỹ: loại trừ có thể kéo theo mất cả vị trí trong Top Stories hiển thị bên trong AI Overviews (theo phân tích của John Shehata, Google chưa xác nhận chính thức).
7 việc cần làm ngay
- Kiểm tra robots.txt: chỉ dùng
user-agent,allow,disallow,sitemap; xóa các dòng “trang trí”/không hợp lệ; percent-encode đường dẫn có ký tự đặc biệt. - Tách bạch crawl vs index: muốn ẩn trang khỏi kết quả, dùng
noindex— và đảm bảo trang đó KHÔNG bị chặn crawl để Google đọc được chỉ thị. - Rà soát thẻ sót: quét toàn site tìm
noindex/Disallow: /còn sót từ môi trường test. - Dùng data-nosnippet đúng chỗ: chỉ loại riêng đoạn nhạy cảm, thay vì
nosnippettoàn trang (vì sẽ mất luôn featured snippet). - Bảo vệ nội dung nhạy cảm bằng mật khẩu/xác thực, không phụ thuộc robots.txt.
- Quyết định về AI có chủ đích: nếu muốn ngoài AI Overviews/AI Mode → tùy chọn Search Console; nếu muốn chặn huấn luyện Gemini → Google-Extended. Đừng nhầm hai cái.
- Mặc định là “mở”: với website thương mại/doanh nghiệp, hãy để nội dung được crawl, index và trích dẫn — và tập trung vào chất lượng, cấu trúc ngữ nghĩa, E-E-A-T.
Câu hỏi thường gặp
Chặn một trang trong robots.txt có khiến nó biến mất khỏi Google không?
Không. robots.txt chỉ ngăn Google thu thập nội dung trang. Nếu Google phát hiện URL qua liên kết từ nơi khác, trang vẫn có thể bị lập chỉ mục (dù không có nội dung mô tả). Muốn trang không xuất hiện, dùng noindex và để trang được phép crawl.
Google-Extended có giúp tôi ra khỏi AI Overviews không?
Không. Google-Extended chỉ kiểm soát việc nội dung được dùng để huấn luyện mô hình Gemini và grounding, không ảnh hưởng việc trang xuất hiện trong AI Overviews hay AI Mode. Để ra khỏi AI Overviews/AI Mode, dùng Search generative AI control trong Search Console.
nosnippet khác data-nosnippet thế nào?
nosnippet là chỉ thị cấp trang, tắt toàn bộ trích đoạn của trang (gồm cả featured snippet). data-nosnippet là thuộc tính HTML cấp đoạn, chỉ loại phần văn bản được gắn thuộc tính — linh hoạt hơn nhiều khi bạn chỉ muốn giấu một đoạn nhỏ.
Các thay đổi này có hiệu lực tại Việt Nam chưa?
Rồi. Đây là các công cụ toàn cầu; tùy chọn Search generative AI control triển khai toàn cầu từ 31/8/2026, hiệu lực sau 1–2 ngày. Tài liệu và video của Google áp dụng cho mọi thị trường, bao gồm Việt Nam.
Kết luận
Bản cập nhật ngày 21/10/2026 không giới thiệu tính năng mới, nhưng nó gom toàn bộ “bảng điều khiển” mà chủ website đang có vào một chỗ — và làm lộ ra điều nhiều người chưa nắm: mỗi công cụ (robots.txt, noindex, nosnippet, data-nosnippet, X-Robots-Tag, Search generative AI control, Google-Extended) kiểm soát một việc khác nhau, không thể thay thế lẫn nhau. Trong kỷ nguyên AI Search, hiểu đúng “thang kiểm soát” này quan trọng ngang với việc tối ưu nội dung: nó giúp bạn vừa bảo vệ cái cần bảo vệ, vừa tránh tự tay cắt đứt con đường để Google — và AI — tìm thấy, hiểu và trích dẫn bạn.
Nguồn tham khảo
- Search Engine Land — “Google has updated its document on how to block Google Search” (Barry Schwartz, 21/10/2026): searchengineland.com
- Google Search Central — “Control what you share with Google Search”: developers.google.com
- Search Engine Roundtable — “Google Explains robots.txt Rules For AI Crawlers…” (video Non-Canonical Cabinet #2, 21/10/2026): seroundtable.com
- PPC Land — “Google lists 7 ways to keep content out of Search, AI opt-out included” (21/10/2026): ppc.land
- Search Engine Journal — “What Opting Out Of Google’s AI Search Features Means Now” (1/8/2026): searchenginejournal.com
- Google — Search generative AI control (Search Console Help): support.google.com
Bài viết liên quan trên MegaSEO: Google cập nhật AI Mode & AI Overviews: thêm inline link · Google trả tiền khi nội dung được dùng trong AI · Search Console chưa đo được thứ hạng AI Search · Visual Semantic SEO